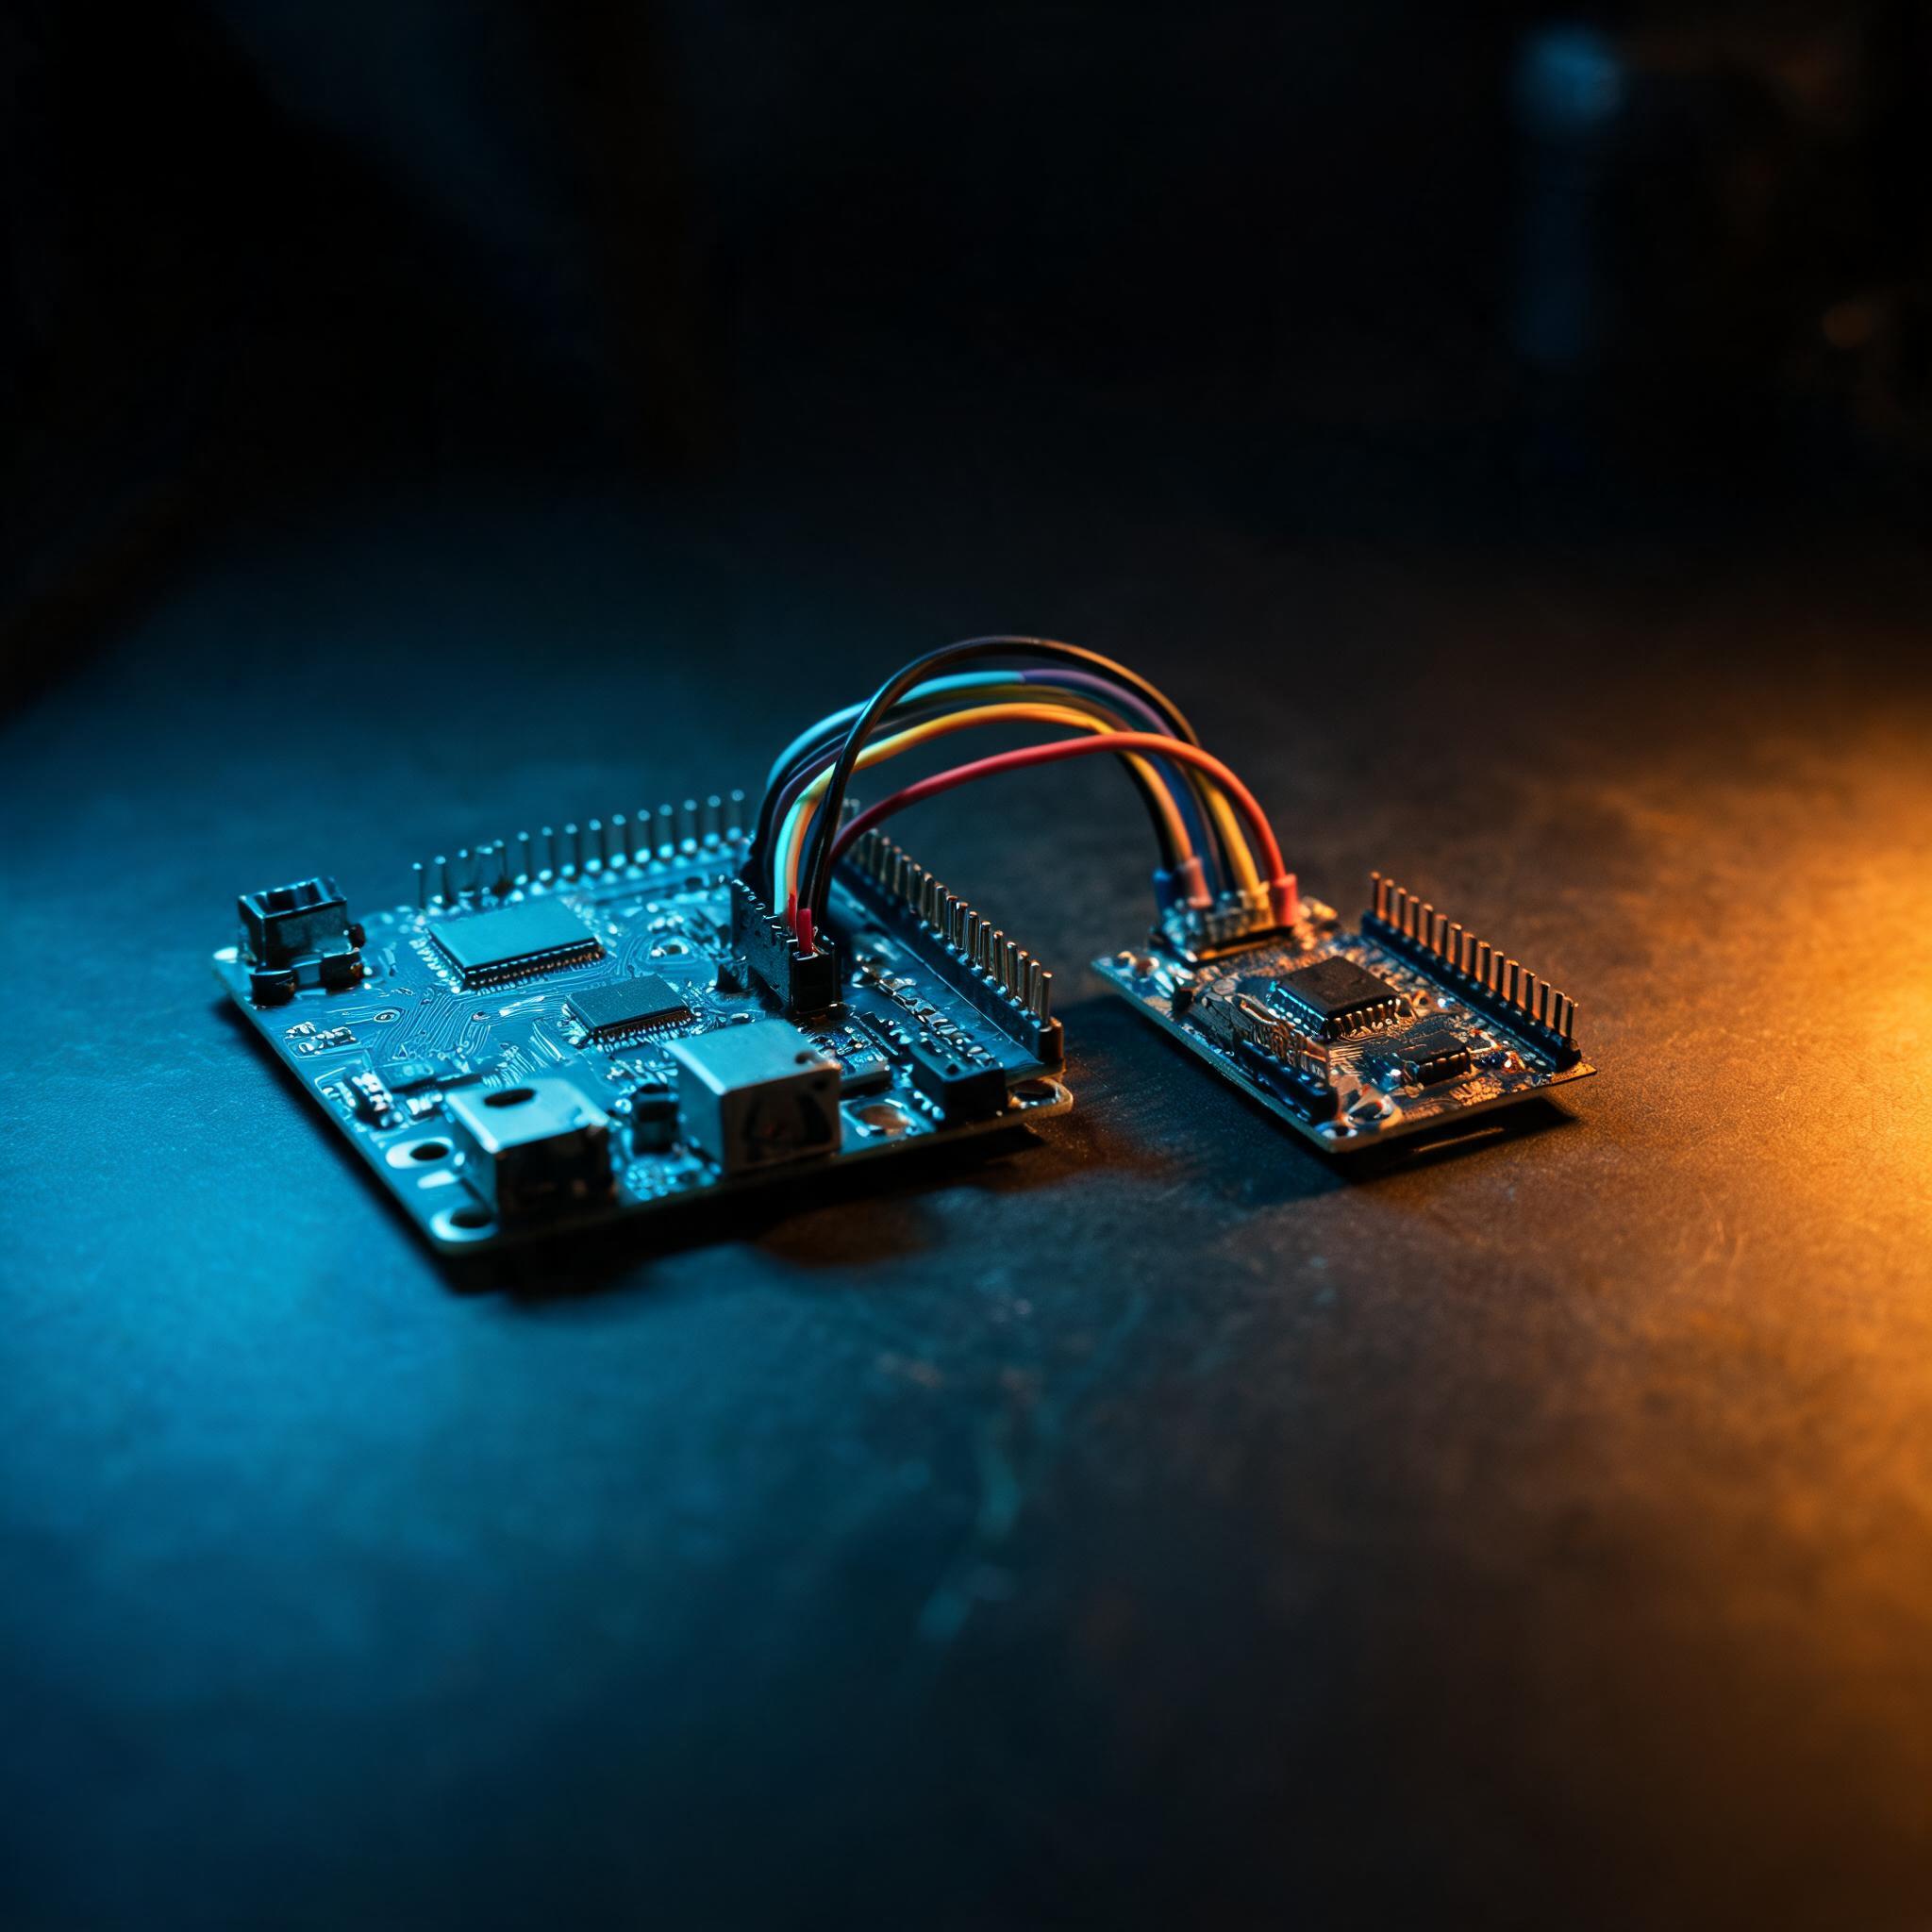
A tentação é colocar tudo na placa: wake word, STT, LLM e TTS num único ESP32-S3. Na prática, o assistente de bancada que sobrevive ao dia a dia é híbrido — o microcontrolador cuida do mundo físico (microfone, alto-falante, display, botão) e um host na mesma rede cuida do trabalho pesado (transcrição, inferência, síntese). Este Projeto 10 da série Assistentes de IA de Bancada mostra a divisão de responsabilidades, o transporte entre as duas pontas e por que esse desenho costuma vencer o “tudo na placa”.
Conceito e arquitetura híbrida
A regra de ouro é separar tempo real de capacidade de computação. O ESP32 é excelente em determinismo de I/O: amostrar I2S sem jitter, acender LEDs com latência previsível, segurar um socket e reagir a um botão. Ele é péssimo em rodar um modelo de linguagem, em carregar um TLS gordo de forma estável e em manter 8 MB de pesos na cabeça. O host (Raspberry Pi, mini-PC ou o próprio PC do dev) é o oposto: sobra CPU/GPU, mas não tem pinos.
Então a fronteira se desenha assim:
| Camada | Onde roda | Por quê |
|---|---|---|
| Captura de áudio I2S, VAD e wake word | ESP32 | Latência determinística, offline, perto do microfone |
| Display, animação de estado, LEDs | ESP32 | Frames locais, sem round-trip pela rede |
| Botão, sensores, GPIO | ESP32 | É o único com acesso ao mundo físico |
| STT (fala -> texto) | Host | Modelo grande (Whisper e afins) que não cabe no micro |
| LLM (Ollama / API) | Host | GPU/RAM de sobra; troca de modelo sem reflash |
| TTS (texto -> fala) | Host | Voz neural local (Piper) ou nuvem |
| Orquestração e ação (rodar teste, commit) | Host | Tem shell, git, IDE e sistema de arquivos |
O transporte também se divide por natureza. MQTT é o canal de controle e estado: tópicos pequenos, QoS, retenção, ideal para “intenção detectada” e “assistente está pensando”. WebSocket é o canal de fluxo contínuo (streaming de áudio ou de tokens) quando você precisa de baixa latência bidirecional. Para quem está começando, um par de tópicos MQTT com payload JSON resolve 90% dos casos — e o mesmo firmware evolui para WebSocket depois.
Lista de peças (BOM)
| Componente | Modelo exato | Função | Faixa de preço |
|---|---|---|---|
| Periférico | ESP32-S3-DevKitC-1 (N16R8) | Áudio I2S, display, GPIO e cliente MQTT/WebSocket | R$ 70–130 |
| Host | Raspberry Pi 4 (4 GB) / Pi 5, ou o próprio PC/macOS do dev | STT + Ollama + TTS + orquestração de ações | R$ 0 (PC) – R$ 700 (Pi 5) |
| Microfone | INMP441 (I2S) | Captura de voz digital, sem ADC ruidoso | R$ 12–30 |
| Amplificador | MAX98357A (I2S) + alto-falante 4 Ω 3 W | Reprodução da resposta em voz | R$ 25–60 |
| Armazenamento host | microSD 32 GB Classe 10 (no Pi) | Imagens do Ollama e modelos locais | R$ 30–60 |
Wiring e cuidados elétricos
| Enlace | Pinos | Observação |
|---|---|---|
| Mic I2S (INMP441) | SCK 14 / WS 15 / SD 13 | Rail analógica separada; L/R no GND. |
| Amp I2S (MAX98357A) | BCLK 16 / LRC 17 / DIN 18 | Bulk cap junto ao 3V3; ganho fixo no SD. |
| Link serial (opcional) | ESP32 TX 43 -> Pi RX (GPIO15); ESP32 RX 44 <- Pi TX (GPIO14) | Cruze TX/RX, terra comum. Ambos 3,3 V: sem level shifter. |
| Transporte de rede | Wi-Fi 2,4 GHz (mesma LAN do broker) | Prefira IP fixo ou mDNS para o broker; evite depender de DHCP volátil. |
| Alimentação | Fontes separadas (USB da placa + fonte do Pi) | Não alimente o Pi pelo regulador da placa; o pico do Pi derruba o S3. |
Código e firmware
No ESP32, o lado físico publica a intenção e escuta a resposta. O tópico de voz carrega JSON curto; o parse é feito com buffer fixo para não fragmentar o heap:
#include <WiFi.h>
#include <PubSubClient.h>
#include <ArduinoJson.h>

WiFiClient net;
PubSubClient mqtt(net);
const char* TOPICO_VOZ  = "bancada/voz";
const char* TOPICO_RESP = "bancada/resposta";

void onMessage(char* topic, byte* payload, unsigned int len) {
  StaticJsonDocument<512> doc;             // fixo: nada de heap aqui
  if (deserializeJson(doc, payload, len)) return;
  const char* acao = doc["acao"] | "";
  if (!strcmp(acao, "falar"))  tocaTexto(doc["texto"] | "");
  if (!strcmp(acao, "estado")) mostraEstado(doc["valor"] | "idle");
}

void reconecta() {
  while (!mqtt.connected()) {
    if (mqtt.connect("bancada-esp32")) mqtt.subscribe(TOPICO_RESP);
    else vTaskDelay(pdMS_TO_TICKS(2000));
  }
}

void publicaIntencao(const char* texto) {
  StaticJsonDocument<256> doc;
  doc["texto"] = texto;
  char buf[256];
  serializeJson(doc, buf);
  mqtt.publish(TOPICO_VOZ, buf);           // acorda o host
}

void loop() {
  if (!mqtt.connected()) reconecta();
  mqtt.loop();
  // ... wake word/ VAD detectou fala -> publicaIntencao("roda os testes")
}
No host, o serviço assina o mesmo tópico, chama o Ollama na rede local e decide a ação. Aqui está o ponto central da arquitetura: o LLM não precisa estar na placa, e a ação (rodar um teste, abrir um arquivo) acontece onde há shell de verdade:
import json, subprocess, requests
import paho.mqtt.client as mqtt

BROKER = "192.168.0.10"
OLLAMA = "http://localhost:11434/api/chat"

def pergunta_llm(texto):
    r = requests.post(OLLAMA, json={
        "model": "qwen2.5:7b",
        "messages": [{"role": "user", "content": texto}],
        "stream": False,
    }, timeout=60)
    return r.json()["message"]["content"]

def executa_acao(intencao):
    low = intencao.lower()
    if "teste" in low:
        subprocess.run(["python", "-m", "pytest"], cwd=".")
    elif "status do git" in low:
        subprocess.run(["git", "status", "--short"])

def on_message(client, userdata, msg):
    texto = json.loads(msg.payload)["texto"]
    resposta = pergunta_llm(texto)
    executa_acao(texto)                      # acao no host, nao na placa
    client.publish("bancada/resposta",
                   json.dumps({"acao": "falar", "texto": resposta}))

c = mqtt.Client()
c.on_message = on_message
c.connect(BROKER, 1883)
c.subscribe("bancada/voz")
c.loop_forever()
Resolução de problemas
- MQTT cai e não volta: keepalive alto com Wi-Fi instável. Baixe o keepalive (15–30 s) e reconecte no
loop(); no broker, aumente o timeout de sessão e use last will para sinalizar queda. - Comandos perdidos: QoS 0 em tópico crítico. Use QoS 1 para a intenção e marque o tópico de estado como retained para o host saber o estado atual ao reconectar.
- TLS no broker torna o micro lento: em LAN confiável, rode o Mosquitto sem TLS e proteja por rede/VPN; se exigir TLS, reserve PSRAM e heap — o handshake come RAM.
- Latência de resposta alta: quase sempre é o LLM, não o transporte. Meça separadamente o tempo de transmissão (ms) e o de inferência (s) para não “otimizar” a rede por engano.
- Host não acha a placa: IP dinâmico. Use mDNS (
bancada-esp32.local) ou DHCP estático. - WebSocket com framing estranho: proxies que remontam buffers. Prefira conexão direta na LAN; evite tunelar áudio por camadas de proxy.
- Ordem de pacotes: WebSocket preserva ordem, mas se você paralelizar publicações, numeradores no JSON evitam respostas cruzadas.
Aplicações reais
Com a divisão pronta, a automação de fluxo por voz deixa de ser ficção de escritório e vira rotina de bancada. Você fala “roda os testes” e o host executa; “o que mudou neste arquivo?” e o LLM lê o git diff e responde em voz enquanto você continua digitando. O teclado nunca é interrompido — o assistente físico absorve o comando e devolve o resultado no canal certo (voz para o resumo, display para o detalhe).
Essa é a tese central da série: o companheiro de bancada não compete com o PC, ele estende o PC para fora da tela. E é por isso que a divisão host + periférico vence: você troca o modelo do Ollama sem reflash, atualiza a lógica de ação sem mexer no firmware e mantém a placa fazendo o que ela faz de melhor.
Para o recorte de assistentes que rodam sem host e sem nuvem, vale reler Assistentes de Voz Offline: Seu Jarvis Pessoal e a dupla Construindo Seu Próprio J.A.R.V.I.S — Parte 1: O Cérebro e Parte 2: Os Sentidos. O fechamento da série vem no próximo post, juntando energia, firmware e arquitetura num roadmap único. Hub: tiolu.com.br/nucleo-hits.
Não some depois da matéria
Radar do hub: Núcleo Hits, Além do Oculto, Bobinho. Sem spray, sem lista comprada.
Radar do hub
Um e-mail quando sair matéria que importa — sem spray de newsletter genérica.
Deixe um comentário
Entre com Google ou Facebook para comentar. Nome e e-mail vêm da sua conta — sem preencher formulário.
Se o login falhar, configure Google e Facebook em Configurações → Nextend Social Login.
Outras opções de login