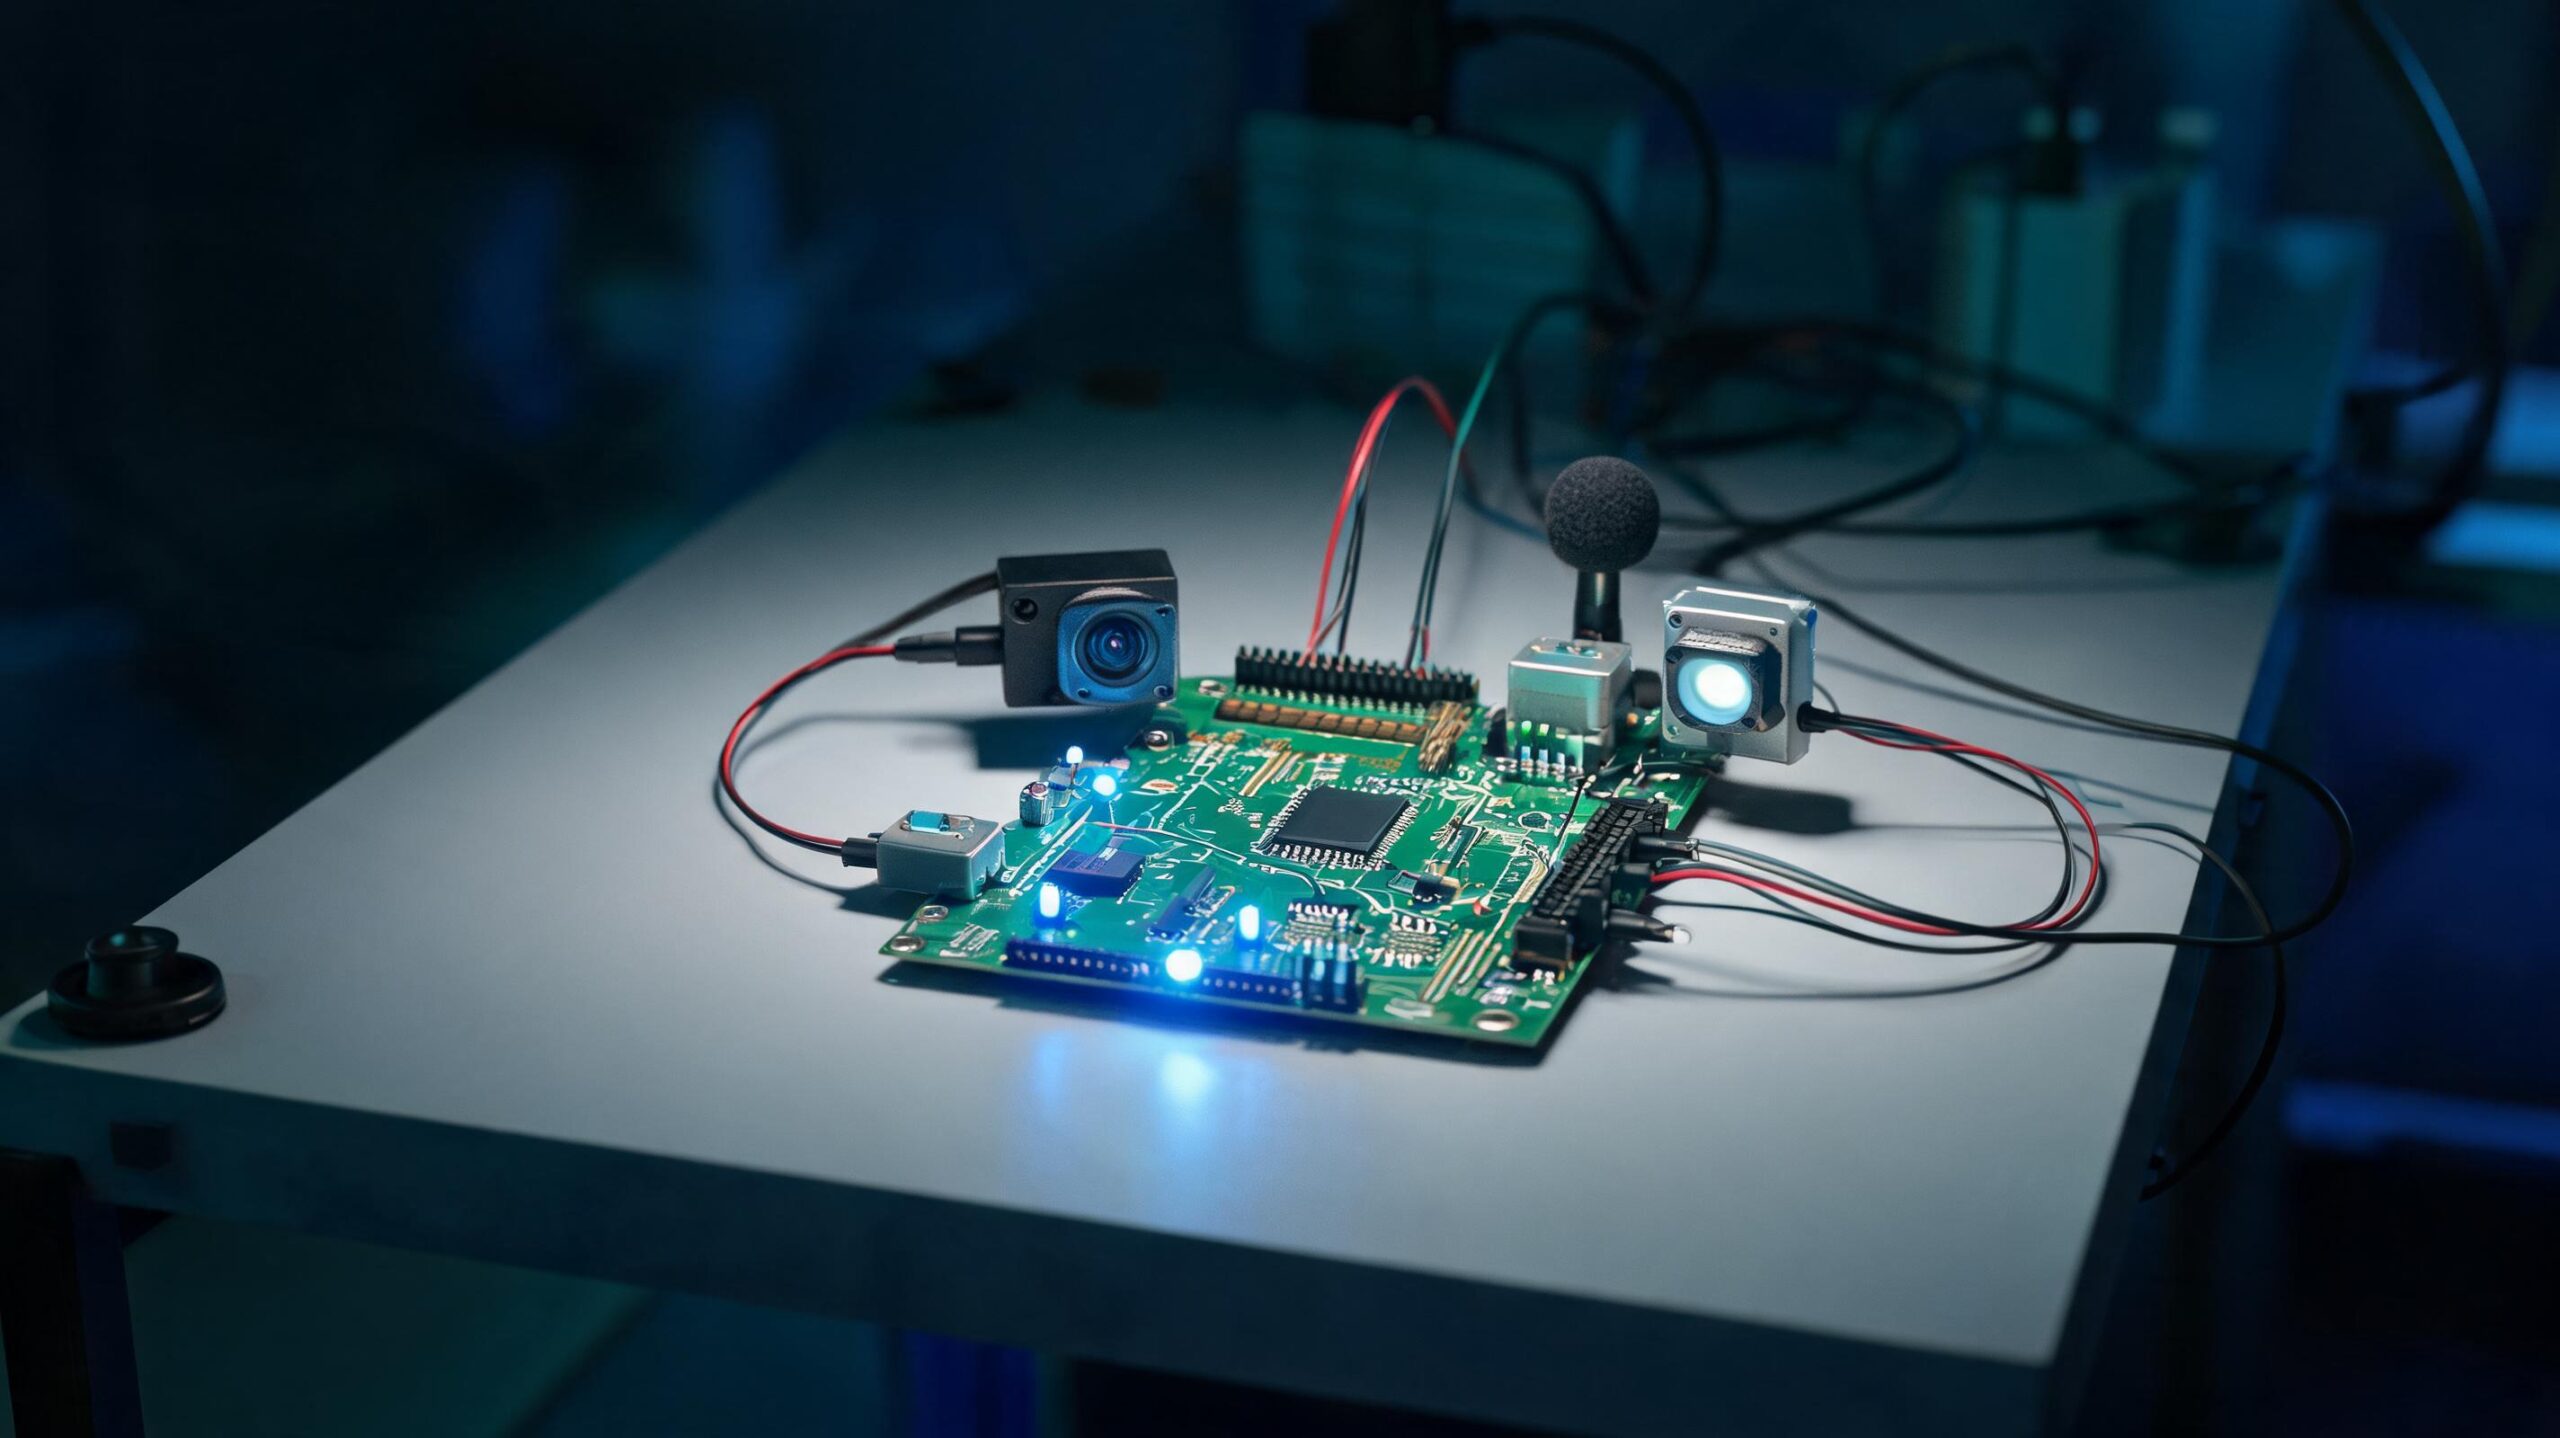
Na Parte 1, construímos o cérebro — um assistente que ouve, pensa e responde. Mas um assistente verdadeiramente inteligente precisa de mais do que um microfone. Ele precisa de sentidos. Visão para saber quem entrou no cômodo. Audição distribuída para ouvir comandos de qualquer lugar da casa. Sensores de presença que detectam não apenas movimento — mas presença humana — distinguindo uma pessoa parada lendo um livro de um ventilador oscilante. Esta é a Parte 2: conectando os nervos periféricos ao cérebro central, transformando sua casa numa entidade que percebe e responde ao ambiente.
Visão Computacional: Quando o Assistente Te Vê
O componente mais transformador de um assistente com sentidos é a visão. Não basta uma câmera IP — você precisa de um sistema que processe o feed de vídeo localmente e extraia informação semanticamente relevante: “tem uma pessoa na sala”, “é o João”, “o gato derrubou algo na cozinha”. O Frigate NVR é a ferramenta definitiva para isso. Ele combina detecção de objetos em tempo real usando TensorFlow Lite (acelerado por Google Coral TPU ou OpenVINO) com gravação inteligente que só armazena eventos relevantes. Um Coral USB de US$60 processa 100+ FPS de detecção — suficiente para 5-8 câmeras simultâneas. O Frigate identifica pessoas, carros, animais, malas, bicicletas e dezenas de outras classes, tudo localmente. A integração com o Home Assistant é nativa: cada detecção vira uma entidade que aciona automações — “se a câmera da porta detectar uma pessoa entre 22h e 06h, acenda todas as luzes e anuncie ‘visitante noturno detectado’ pelo Piper TTS”.
Para ir além da detecção de objetos genéricos e chegar ao reconhecimento facial, o Frigate suporta um sub-sistema de reconhecimento via Double Take e CompreFace. O fluxo: a câmera captura o rosto → Frigate detecta uma pessoa → CompreFace compara com um banco de faces conhecidas → Home Assistant sabe quem entrou e pode personalizar a resposta. “Bem-vindo de volta, Maria. A temperatura da sala está em 23 graus. Quer que eu prepare o modo cinema?” — tudo 100% local, nenhuma imagem saindo de casa.
Microfones Distribuídos: ESP32 + I2S MEMS em Cada Cômodo
Um único microfone no escritório não basta — o assistente precisa ouvir você na cozinha, no quarto, na garagem. A solução: ESPHome com microfones digitais I2S MEMS (como o INMP441, precisão de 24 bits, SNR de 61 dBA) espalhados pela casa. Cada nó custa menos de R$50: um ESP32 DevKit, o microfone INMP441 e uma fonte de 5V — tudo conectado via Wi-Fi ao Home Assistant. O ESPHome expõe o áudio como um stream que o Assist do Home Assistant consome diretamente. O Home Assistant Voice Preview Edition é uma versão integrada desse conceito — um hardware pronto que combina ESP32-S3, microfone, alto-falante e botão físico num formato elegante. Mas você pode construir seus próprios nós por 1/5 do preço com a mesma funcionalidade básica.
Sensores de Presença mmWave: O Fim do PIR Burro
Sensores de movimento PIR (infravermelho passivo) são o padrão da automação residencial há décadas — e são terríveis. Eles só detectam mudança de calor, então uma pessoa parada lendo no sofá é invisível depois de 30 segundos. Sensores mmWave como o LD2410 mudam completamente o jogo. Eles emitem ondas de rádio de 24 GHz e medem o reflexo — detectando tanto movimento grosso (“alguém andando”) quanto presença estática (“alguém respirando”). O módulo custa R$45 e é integrado ao ESPHome com configuração mínima de YAML. O resultado: o assistente sabe se tem gente no cômodo mesmo se ninguém se mexer. Luzes nunca mais apagam em cima de você durante uma maratona de séries.
A integração MQTT é o que costura todos esses sensores. Cada nó (microfone, sensor de presença, câmera) publica suas leituras num broker MQTT local (Mosquitto), e o Home Assistant consome essas mensagens para atualizar seu grafo de estado em tempo real. O barramento MQTT é o sistema circulatório da casa inteligente — e como roda localmente, a latência é de milissegundos, não de segundos como seria com uma API na nuvem.
Projeto Prático: O Espelho Inteligente Completo
Um espelho mágico (MagicMirror²) com display atrás de vidro semi-espelhado é o projeto-síntese de tudo que cobrimos nesta série. O hardware: um monitor IPS de 24 polegadas desmontado (ou um laptop velho com tela funcional), vidro espelhado bidirecional cortado sob medida, Raspberry Pi 5, câmera USB com sensor Sony IMX, microfone I2S MEMS e alto-falantes estéreo. O software: MagicMirror² como framework de dashboard (mostrando clima, calendário, notícias, indicadores de saúde via sensores), CompreFace para reconhecimento facial, Frigate para detecção de presença, Whisper + Ollama + Piper para o assistente de voz. Quando você se aproxima, a câmera detecta seu rosto, o CompreFace identifica você, e o espelho carrega seu perfil personalizado — sua agenda, seus sensores de saúde, suas preferências de iluminação. Você pergunta “como está meu sono hoje?” e o Ollama consulta os dados dos sensores da sua cama (com um sensor de pressão DIY ou um Withings Sleep Analyzer integrado) e responde com um resumo. O espelho de Branca de Neve nunca foi tão útil — e nunca rodou num Linux.
A Casa Como Organismo Cibernético
No universo de Ghost in the Shell, a linha entre humano, máquina e ambiente se dissolve — corpos têm Wi-Fi, casas têm consciência, a cidade inteira é um organismo cibernético. O projeto de construir um assistente com sentidos não é sobre automação — é sobre aumento. Sua casa que te vê, te ouve e responde não é uma casa mais preguiçosa — é uma casa mais presente. E o fato de que isso é possível com hardware de consumo, software open-source e um fim de semana de solda e YAML é, em si, uma declaração sobre o estado da tecnologia em 2026. O futuro não está num data center distante — está no espelho do seu banheiro, rodando num Pi 5, esperando você dizer bom dia.
Fontes e Referências
- Frigate NVR — NVR com detecção de objetos local e IA
- CompreFace — Reconhecimento facial open-source (GitHub)
- ESPHome — Firmware open-source para ESP32/ESP8266
- LD2410 mmWave Sensor — Documentação ESPHome
- Home Assistant Voice Preview Edition
- MagicMirror² — Framework de espelho inteligente
- OpenCV — Biblioteca de visão computacional open-source
- Eclipse Mosquitto — Broker MQTT open-source
- Shirow, Masamune. Ghost in the Shell. Kodansha, 1989.