Você já quis ter um assistente de voz que não manda seus dados para uma corporação? Que não depende de internet, não tem mensalidade e não grava suas conversas para “melhorar o serviço”? Em 2026, isso não é mais ficção — é um projeto de fim de semana com um Raspberry Pi 5 e três ferramentas open-source: Whisper para ouvir, Ollama para pensar, Piper TTS para falar. E o melhor: tudo roda offline, na sua mesa, sem enviar um byte para fora da sua rede.
O Pipeline de Voz Local
O fluxo é elegante na sua simplicidade:
- Captura de áudio: Um microfone USB capta sua voz. O sistema detecta quando você começa a falar (VAD — Voice Activity Detection) e grava até você terminar.
- STT (Speech-to-Text): O áudio é transcrito para texto pelo Whisper, modelo da OpenAI que roda 100% local.
- LLM (Large Language Model): O texto transcrito é enviado para um modelo de linguagem rodando no Ollama. Ele processa o comando e gera uma resposta em texto.
- TTS (Text-to-Speech): A resposta textual é convertida em áudio pelo Piper TTS, um sintetizador de voz neural rápido e leve.
- Reprodução: O áudio é tocado nos alto-falantes conectados ao Pi.
Esse pipeline inteiro roda num Raspberry Pi 5 com 8 GB de RAM — sem GPU externa, sem assinatura, sem servidor remoto. Vamos montar isso.
Hardware Necessário
- Raspberry Pi 5 (8 GB): ~R$ 750 na Robocore. Os 8 GB são importantes — modelos de linguagem consomem RAM vorazmente.
- Microfone USB: Um simples microfone USB de mesa (~R$ 50-80) funciona bem para testes. Se quiser qualidade, microfones como Blue Snowball ou Fifine (~R$ 200-350) captam voz com mais clareza em ambientes com ruído.
- Alto-falante ou caixa de som: Qualquer caixa com entrada P2 ou USB. O Pi 5 tem saída de áudio P2 integrada e suporte a áudio via HDMI e Bluetooth.
- MicroSD de 64 GB ou SSD USB: Os modelos ocupam espaço — o Whisper base (~150 MB), um LLM pequeno como Llama 3.2 3B (~2 GB) e o Piper (~50 MB). Com SSD NVMe via HAT, a inicialização dos modelos é instantânea.
Passo 1: Instalar o Whisper (STT)
O Whisper é o melhor reconhecedor de fala open-source disponível. A versão C++ (whisper.cpp) é otimizada para rodar em CPUs ARM — ideal para o Pi 5.
# Clone e compile o whisper.cpp sudo apt install git cmake -y git clone https://github.com/ggerganov/whisper.cpp cd whisper.cpp # Baixe o modelo (tiny, base, small, medium, large) # Para Pi 5 8GB: use small (excelente trade-off velocidade x precisão) bash ./models/download-ggml-model.sh small # Compile cmake -B build && cmake --build build --config Release Teste rápido: grave um áudio de 5 segundos (arecord -f cd -d 5 test.wav), depois execute ./build/bin/whisper-cli -m models/ggml-small.bin -f test.wav. Em segundos, o Whisper transcreve o áudio. No Pi 5, o modelo small processa ~1 segundo de áudio em ~1.5 segundos — quase tempo real. O modelo medium é mais preciso, mas ~2x mais lento.
Passo 2: Instalar o Ollama (LLM)
O Ollama é a plataforma que tornou LLMs locais acessíveis. Com um comando, você baixa e roda modelos quantizados otimizados para CPU.
# Instale o Ollama no Pi 5 (ARM64) curl -fsSL https://ollama.com/install.sh | sh # Puxe um modelo leve para o Pi 5 # Opções por ordem de peso: # - phi (1.6GB): Microsoft Phi-3 mini — rápido, inteligente, cabe em 8GB com folga # - llama3.2:3b (2GB): Meta Llama 3.2 3B — excelente qualidade geral # - mistral (4.1GB): Mistral 7B — melhor qualidade, mas o Pi 5 sofre com modelos >4GB ollama pull phi # Teste ollama run phi "Qual é a capital do Brasil? Responda em uma frase." O modelo Phi-3 mini é surpreendentemente capaz. Responde perguntas complexas, entende contexto, faz piadas. A latência no Pi 5 é de 3-5 segundos para respostas curtas — aceitável para um assistente de voz onde você já espera uma pausa natural.
Passo 3: Instalar o Piper TTS (Text-to-Speech)
Piper TTS é um sintetizador de voz neural desenvolvido para o ecossistema Rhasspy/Home Assistant. É rápido, leve, e tem vozes em português brasileiro.
# Instale o Piper via pip pip3 install piper-tts # Baixe vozes em português # Vozes disponíveis: pt_BR-faber-medium, pt_BR-edresson-medium, pt_BR-female-medium wget https://huggingface.co/rhasspy/piper-voices/resolve/main/pt/pt_BR/faber/medium/pt_BR-faber-medium.onnx wget https://huggingface.co/rhasspy/piper-voices/resolve/main/pt/pt_BR/faber/medium/pt_BR-faber-medium.onnx.json # Teste echo "Olá! Eu sou seu assistente pessoal funcionando completamente offline." | piper \ --model pt_BR-faber-medium.onnx --output_raw | aplay -r 22050 -f S16_LE -t raw -c 1 A voz do Piper em português é natural — não vai ganhar Emmy, mas é perfeitamente compreensível e não tem aquele tom robótico do eSpeak. Os modelos “medium” são o sweet spot entre qualidade e velocidade no Pi 5.
Passo 4: Integrar Tudo — O Assistente Completo
Com as três peças funcionando individualmente, o próximo passo é o script de integração. Este é um assistente de voz simplificado que faz o pipeline completo:
#!/bin/bash # assistente.sh — Pipeline de voz offline completo AUDIO_FILE="/tmp/comando.wav" RESPONSE_TEXT="/tmp/resposta.txt" RESPONSE_AUDIO="/tmp/resposta.wav" echo "🎤 Assistente ouvindo..." # 1. Grava áudio (5 segundos ou até silêncio) # -d 5 = duração máxima de 5 segundos arecord -f cd -d 5 -D plughw:1,0 $AUDIO_FILE # 2. STT: Whisper transcreve echo "🧠 Processando..." TRANSCRIPTION=$(/home/pi/whisper.cpp/build/bin/whisper-cli \ -m /home/pi/whisper.cpp/models/ggml-small.bin \ -f $AUDIO_FILE --no-timestamps -l pt 2>/dev/null | tail -1) echo "Você disse: $TRANSCRIPTION" # 3. LLM: Ollama processa ollama run phi "Você é um assistente pessoal útil e conciso chamado Jarvis. Responda esta pergunta em português, em no máximo 2 frases: $TRANSCRIPTION" > $RESPONSE_TEXT RESPONSE=$(cat $RESPONSE_TEXT) echo "Jarvis: $RESPONSE" # 4. TTS: Piper fala echo "$RESPONSE" | piper \ --model /home/pi/pt_BR-faber-medium.onnx \ --output_file $RESPONSE_AUDIO # 5. Reproduz aplay $RESPONSE_AUDIO echo "✅ Pronto!" Coloque a palavra-chave “Jarvis” no início de cada comando e você tem efetivamente seu próprio assistente de voz offline. Para o modo sempre ouvindo (hotword), adicione o Picovoice Porcupine — ele detecta wake words como “Hey Jarvis” localmente com latência de milissegundos.
Extras: Integração com Home Assistant
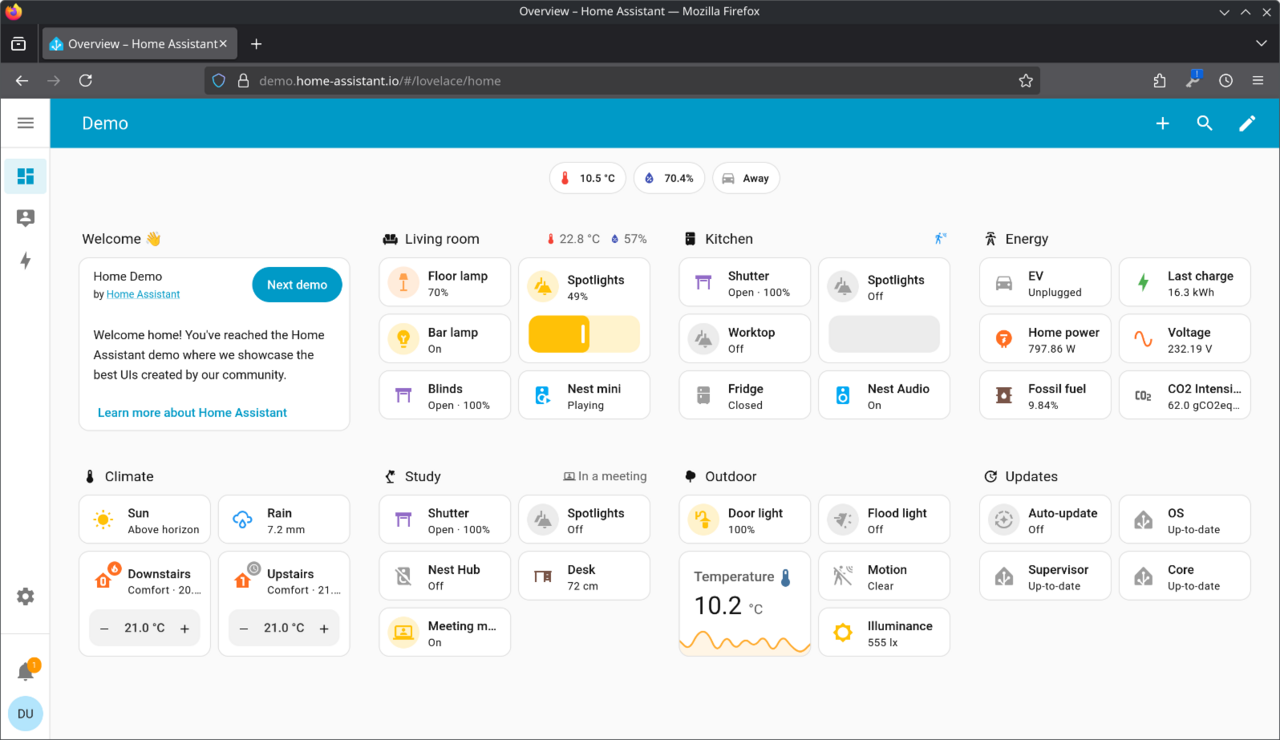
O projeto fica exponencialmente mais útil quando você conecta o assistente ao Home Assistant. O Home Assistant tem uma API REST rica: você pode acionar automações, ler estados de sensores e controlar dispositivos com comandos de voz processados pelo Ollama. Imagine: “Jarvis, acenda a luz da sala” → Whisper transcreve → Ollama interpreta a intenção → seu script chama a API do Home Assistant → luz acende. Tudo local. Tudo seu.
Limitações e Realidade
Este assistente não compete com Alexa ou Google Assistant em velocidade ou reconhecimento de intenções complexas — o Phi-3 no Pi 5 tem ~3B de parâmetros vs centenas de bilhões na nuvem. Mas o que ele perde em potência bruta, ganha em privacidade, independência e a satisfação de ser 100% seu. E os modelos melhoram a cada mês — em 2027, o mesmo Pi 5 vai rodar LLMs que hoje exigem servidores.
Como todo projeto maker, o assistente offline é um ponto de partida. Cada atualização de modelo, cada microfone melhor, cada integração nova é um upgrade que VOCÊ decide fazer. Sem contrato. Sem EULA de 80 páginas. Sem servidor te ouvindo 24/7. Só você, seu Pi, e a pergunta “o que mais eu posso automatizar?”.
Fontes e Referências
- whisper.cpp — Implementação C++ otimizada do Whisper
- Ollama — Plataforma para rodar LLMs localmente
- Piper TTS — Sintetizador de voz neural rápido e leve
- Home Assistant — Plataforma open-source de automação residencial
- Picovoice Porcupine — Wake word detection on-device
- Microsoft Phi-3 no Ollama
- Raspberry Pi 5 — Especificações oficiais
- Raspberry Pi 5 na Robocore